Leonid 为一家规模虽小但前景远大的初创公司工作,该公司致力于解码人类基因组。他的职责包括解决这样一类复杂问题:在由字母 'A'、'T'、'G' 和 'C' 组成的长字符串中寻找特定模式。
让我们考虑如下情形。现在有一段记录为字符串 S 的人类 DNA 链片段。为了分析该片段,需要在字符串 S 中找到字符串 T 的所有出现位置。然而,问题因原始链片段可能包含一些微小突变而变得复杂,尽管这些突变很小,却增加了寻找片段的难度。Leonid 提出了以下方法来解决这个问题。
记整数 k ≥ 0 为错误阈值。我们称字符串 T 在字符串 S 的位置 i(1 ≤ i ≤ |S| - |T| + 1)处出现,当把字符串 T 从该位置开始对齐后,字符串 T 的每个字符都能在字符串 S 中找到一个值相同的字符,且两者的位置距离至多为 k。更形式化地说,对于任意 j(1 ≤ j ≤ |T|),都必须存在某个 p(1 ≤ p ≤ |S|),使得 |(i + j - 1) - p| ≤ k 且 S[p] = T[j]。
例如,根据上述定义,字符串“ACAT”在字符串“AGCAATTCAT”中的位置 2、3 和 6 处出现。
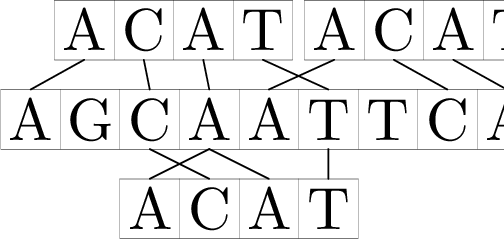
注意,当 k = 0 时,上述定义就变成了字符串在另一个字符串中出现的简单定义。
请帮助 Leonid 计算给定字符串 T 在给定字符串 S 中按照给定错误阈值出现的位置数。
输入
第一行包含三个整数 |S|, |T|, k(1 ≤ |T| ≤ |S| ≤ 200 000,0 ≤ k ≤ 200 000)— 字符串 S 和 T 的长度以及错误阈值。
第二行包含字符串 S。
第三行包含字符串 T。
两个字符串均只由大写字母 'A'、'T'、'G' 和 'C' 组成。
输出
按照上述定义,输出一个数字,即字符串 T 在字符串 S 中以错误阈值 k 出现的次数。
示例
输入复制
10 4 1
AGCAATTCAT
ACAT
输出复制
3
注
如果你对人类基因组结构的了解碰巧比本题作者更多,并且对 Leonid 最初提出的方法不以为然,那么不必认真对待上面所描述的一切。