← 返回题目列表

AtCoder · yuha_c83_03

C. 树状图 - 树状图

中文机器翻译题面 查看原题

問題文

内森。 O. Davis 是信息工程系的学生。 他正在为他所在系的“人工智能概论”课程的期末作业编写一个层次聚类程序。
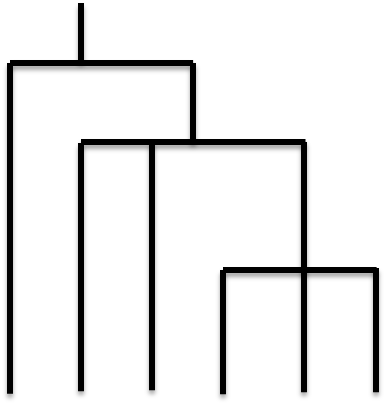
聚类是将一组对象划分为多个称为聚类的子集的过程。 这里,属于同一簇的对象根据某种标准被确定为相似的。 层次聚类是一种间接执行此操作的方法,并将对象集合视为树形结构(称为树状图)。 然而,在这个问题中,树的集合也被视为树状图。树状图表示对象之间的相似程度。树形图的示例如下所示。
图:美丽的树图
在上图中,末端叶子代表每个对象。 水平线段表示将对象集合划分为两个或多个子组。属于不同子组的对象相似度较低; 属于同一子组的对象表示高度相似。 这表明水平线位置越高,属于该水平线的对象或对象组的相似性越低。 作为示例,您可以看到上图顶部的第二条水平线将对象集划分为三个集群。
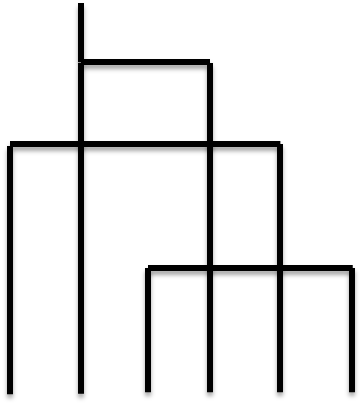
Nathan编写的程序可以输出系统发育树,但它包含两个错误。 第一点是系统发育树是不连通的,即输出的系统发育树由多个树结构组成。本期我们不讨论这个问题。 第二点是输出的系统发育树看起来很脏。具体来说,线段彼此相交,如图(图:脏树图)所示。
图:脏树图
这使得阅读变得困难。 你的工作是编写一个程序,接收 Nathan 输出的系统发育树作为输入,并输出一个漂亮的系统发育树。 在这里,美丽的系统发育树是垂直线段和水平线段除了接触点之外不接触的树,并且终端叶的数量按字典顺序是最年轻的。
详细规格请参阅输入和输出栏。

入力

输入格式如下。
N M Q
SplitInfo_{1}
SplitInfo_{2}
...
SplitInfo_{M}
Query_{1}
Query_{2}
...
Query_{Q}
第一行是 3 个整数 N ( 1 ≤ N ≤ 100,000 )、 M ( 0 ≤ M < N )、 Q ( 1 ≤ Q ≤ 1,000 , Q ≤ N )。 N 是对象的数量, M 是水平线段的数量, Q 表示查询次数。
继续 M 行提供有关水平线段的信息。每行的格式如下。
Y L V_1 V_2 ... V_L
Y ( 0 ≤ Y ≤ 10^9 ) 表示每条水平线上方和下方的位置,坐标越小,位置越高(相似度越低)。输入时Y保证为不同的值。 L (2 ≤ L) 表示连接到水平线的垂直线段(对象或对象集合)的数量。 V_i ( 1 ≤ i ≤ L ) 各自代表一条垂直线段。每个对象从1开始,没有重复 表示为 N 以内的整数。此外,对象集由代表属于该集合的任何对象的整数来表示。 彼此不同 关于i, j,V_{i} = V_{j}喜欢SplitInfo不存在。
继续 Q 行,其中一个整数代表每一行的查询 I_{i} 。

出力

每次输入查询 关于 I_{i} ,从美丽的系统发育树的左侧开始 打印代表第 I_{i} 个叶对象的整数。这里 I_{i} 应从1开始。 如果仅对满足

部分点

  • 1 ≤ N ≤ 8 的输入给出正确答案,则部分点为 将奖励 50 积分

入力例 1

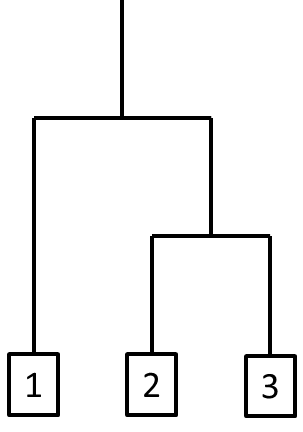
3 2 3
10 2 1 2
20 2 3 2
1
2
3

出力例 1

1
2
3
入力例 2

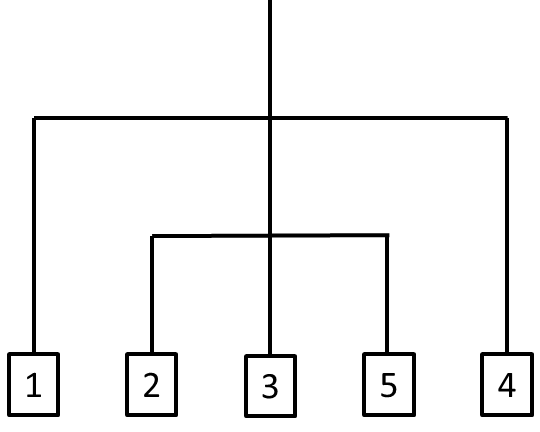
5 2 5
10 3 1 2 4
20 3 2 3 5
1
2
3
4
5

出力例 2

1
2
3
5
4
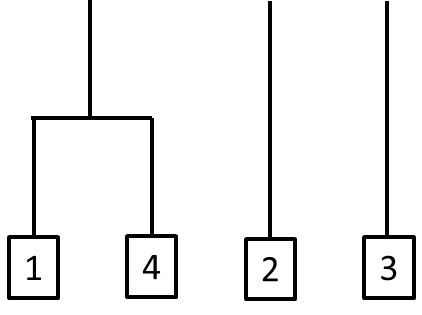
入力例3

4 1 4
10 2 1 4
1
2
3
4

出力例 3

1
4
2
3
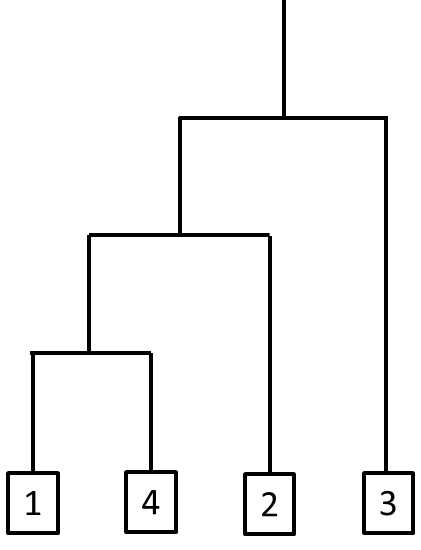
入力例 4

4 3 4
30 2 1 4
20 2 2 4
10 2 3 4
1
2
3
4

出力例 4

1
4
2
3
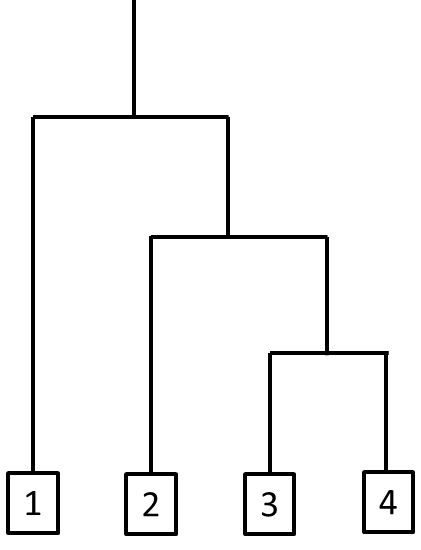
入力例 5

4 3 4
10 2 1 4
20 2 2 4
30 2 3 4
1
2
3
4

出力例 5

1
2
3
4
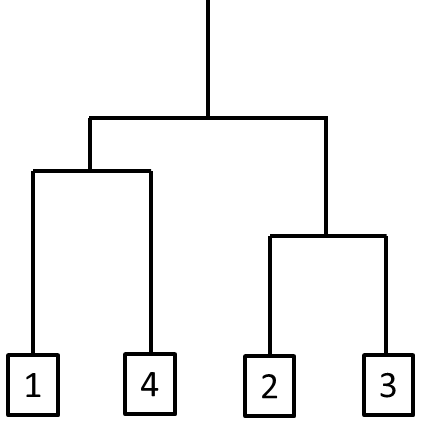
入力例 6

4 3 4
10 2 1 2
15 2 1 4
20 2 2 3
1
2
3
4

出力例 6

1
4
2
3
入力例 7

3 2 3
10 2 2 3
20 2 1 2
1
2
3

出力例 7

1
2
3
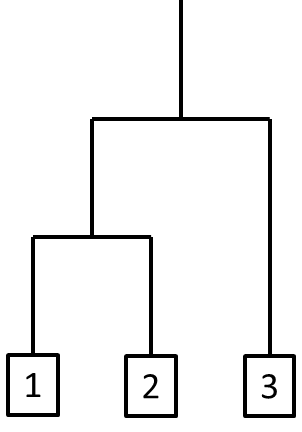
入力例 8

1 0 1
1

出力例 8

1
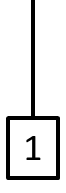
由于该问题的输入数据量较大,从速度角度考虑,我们不建议使用C++的cin或Java的Scanner。我们建议使用 scanf() 或 StringTokenizer。