内容
问题概述
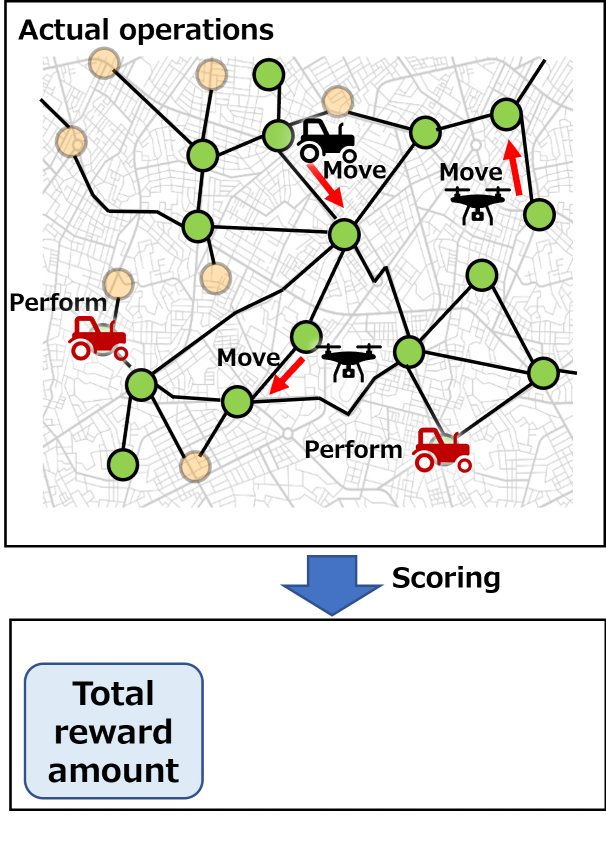
这个问题是为了农业设备共享服务,最大限度地利用可用的机械和人员(简单地称为“工人”),执行农业工作(称为“工作”),同时最大化奖励*。输出向工人移动和执行工作的指令,以处理分布在空间上的许多工作。每个作业由多个需要特定处理量的“任务”组成,当工人完成这些任务时才被认为完成。工作,但奖励的金额取决于任务完成的时间,因此必须考虑处理每项任务的适当时间范围。工人在特定时间可以处理的任务数量也取决于工人的能力。
*奖励:假设农作物的收获时间和农业设备的可再生能源供应率等因素。
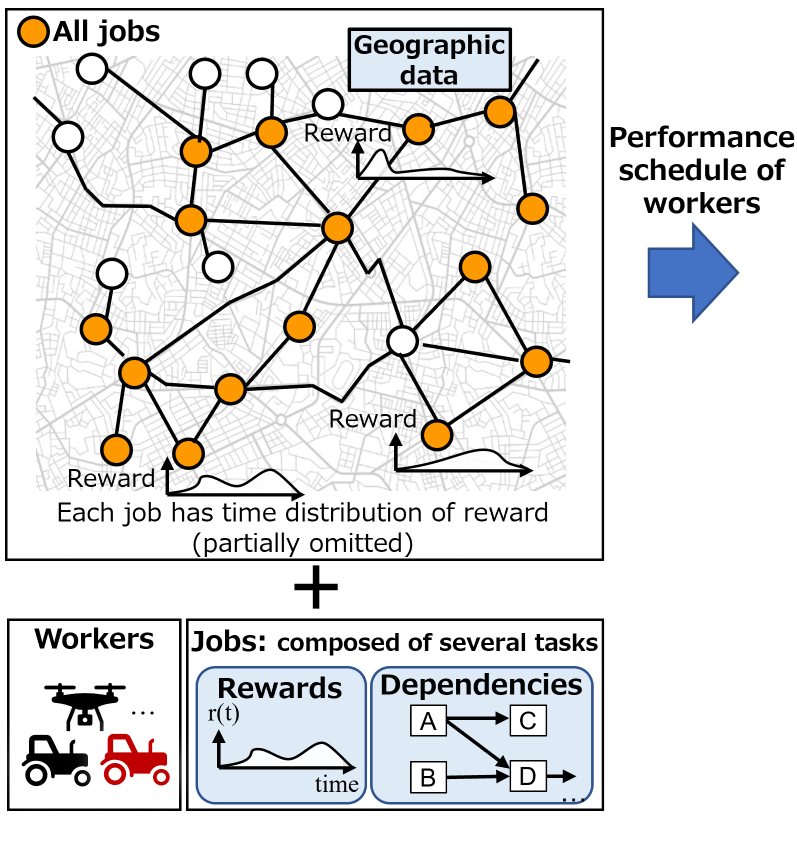
以下数据作为初始输入给出。
- 工作时间范围
- 地理数据(图表)
- 工人数据
- 所有作业数据
对于此输入,参赛者将产生以下输出:
- 工作时间范围内所有时间点的工作人员操作。
工作获得的总奖励将是分数。
下面给出更详细的描述。
输入 1
初始输入为:
- 工作时间范围
- 地理数据(图)
- 工人数据
- 所有作业数据
该数据以以下格式在标准输入上给出:
T_{\rm{max}}\\
N_V\,\,N_E\\
u_1\quad v_1\quad d_1\\
\vdots\\
u_{N_E}\,\, v_{N_E}\,\, d_{N_E}\\
N_{\rm{worker}}\\
v^{\rm{init}}_1\,\,L^\text{max}_1\,\,N^{\rm{JobType}}_1\,\,\text{Type}^1_1\,\,\text{Type}^1_2\,\,\cdots \text{Type}^1_{N^{\rm{JobType}}_1}\\
\vdots\\
v^{\rm{init}}_{N_{\rm{worker}}}\,\,L^\text{max}_{N_{\rm{worker}}}\,\,N^{\rm{JobType}}_{N_{\rm{worker}}}\,\,\text{Type}^{N_{\rm{worker}}}_1\,\,\text{Type}^{N_{\rm{worker}}}_2\,\,\cdots \text{Type}^{N_{\rm{worker}}}_{N^{\rm{JobType}}_1}\\
N_{\rm{job}}\\
\text{Job}_1\\
\vdots\\
\text{Job}_{N_{\rm{job}}}
工作时间范围
- 输入
- 工作时间范围的长度,T_\text{max},在第一行给出。
对于这个问题,时间值, t,将为整数值 1 to T_{\text{max}}.
输入示例
以下是一个示例 T_\text{max}=300
300
(该行以换行符结束)
地理数据
- 输入
- 下一行给出顶点数, N_V和边缘, N_E,用于表示问题的地理数据的图(具有正权重的连通无向图)。
- 的 N_V 各个顶点的编号将从 1 to N_V.
- 以下 N_E 行给出每条边的数据:顶点 u_i,v_i和重量 d_i (距离)。请注意 1\leq i \leq N_E.
- 下一行给出顶点数, N_V和边缘, N_E,用于表示问题的地理数据的图(具有正权重的连通无向图)。
如下所述, 职位 位于顶点并且 工人 沿着该图的边缘移动。
输入示例
以下是一个示例 N_V=14,N_E=19:
14 19
1 7 1
1 2 1
2 9 1
2 3 1
3 5 1
3 7 1
3 6 1
4 13 2
4 10 2
4 6 1
4 5 1
6 8 1
7 8 1
8 14 2
9 11 2
10 12 2
10 11 2
12 13 2
13 14 2
(最后一行以换行符结束)
- 第 1 行:该图有
14顶点和19边缘(N_V=14,N_E=19).- 顶点索引来自 1 to
14分配给这些14顶点。 - 下面,顶点索引对应的顶点 i 将简称为顶点 i.
- 顶点索引来自 1 to
- 第 2 行:有一个长度为边的边
1顶点之间1和7(u_{1}=1,v_{1}=7,d_{1}=1). - 第 3 行:有一个长度为边的边
1顶点之间1和2(u_{2}=1,v_{2}=2,d_{2}=1). - 第 4 行:有一个长度为边的边
1顶点之间2和9(u_{3}=2,v_{3}=9,d_{3}=1). - 第5行:有一个长度为边的边
1顶点之间2和3(u_{4}=2,v_{4}=3,d_{4}=1). - 第6行:有一个长度为边的边
1顶点之间3和5(u_{5}=3,v_{5}=5,d_{5}=1). - 第7行:有一个长度为边的边
1顶点之间3和7(u_{6}=3,v_{6}=7,d_{6}=1). - 第 8 行:有一个长度为边的边
1顶点之间3和6(u_{7}=3,v_{7}=6,d_{7}=1). - 第9行:有一个长度为边的边
2顶点之间4和13(u_{8}=4,v_{8}=13,d_{8}=2). - 第10行:有一个长度为边的边
2顶点之间4和10(u_{9}=4,v_{9}=10,d_{9}=2). - 第11行:有一个长度为边的边
1顶点之间4和6(u_{10}=4,v_{10}=6,d_{10}=1). - 第12行:有一个长度为边的边
1顶点之间4和5(u_{11}=4,v_{11}=5,d_{11}=1). - 第13行:有一个长度为边的边
1顶点之间6和8(u_{12}=6,v_{12}=8,d_{12}=1). - 第14行:有一个长度为边的边
1顶点之间7和8(u_{13}=7,v_{13}=8,d_{13}=1). - 第15行:有一个长度为边的边
2顶点之间8和14(u_{14}=8,v_{14}=14,d_{14}=2). - 第16行:有一个长度为边的边
2顶点之间9和11(u_{15}=9,v_{15}=11,d_{15}=2). - 第17行:有一个长度为边的边
2顶点之间10和12(u_{16}=10,v_{16}=12,d_{16}=2). - 第18行:有一个长度为边的边
2顶点之间10和11(u_{17}=10,v_{17}=11,d_{17}=2). - 第19行:有一个长度为边的边
2顶点之间12和13(u_{18}=12,v_{18}=13,d_{18}=2). - 第 20 行(=1+N_E): 有一条长度为边的边
2顶点之间13和14(u_{19}=13,v_{19}=14,d_{19}=2).
工人
工作人员是处理作业的实体,并且具有移动和执行任务的能力。他们根据参赛者的输入进行操作(参见 工人行动).
- 输入
- 工人数量, N_{\text{worker}},在下一行给出。
接下来是 N_{\text{worker}} 行包含工作配置数据:
- 初始位置(顶点索引): v^{\text{init}}_i
- 工人每单位时间可以执行的最大任务数: L^{\text{max}}_i
- 工人可以执行的工作类型数量, N^{\text{JobType}}_i ,以及作业类型列表: \text{Type}^i_1\,\,\text{Type}^i_2\,\,\cdots\,\,\text{Type}^i_{N^{\text{JobType}}_i}
这些输入按工作人员 ID 的顺序给出。
每个工人每单位时间可执行的任务数量上限以及可完成的作业类型都不同。
输入示例
以下是一个示例 N_{\text{worker}}=5:
5
6 100 3 1 2 3
13 59 1 3
10 55 2 2 3
9 47 3 1 2 3
9 89 1 2
(最后一行以换行符结束)
- 第 1 行:有
5工人(N_{\text{worker}}=5). - 第 2 行:ID=1 的工作人员的描述符。
- 工人的初始位置是具有顶点索引的顶点
6(v^{\text{init}}_1=6). - 该工作人员每单位时间可以执行的最大任务数为
100(L^{\text{max}}_1=100). - 工人可以执行
3工作类型 (N^{\text{JobType}}_1=3),类型1,2,3(\text{Type}^1_1=1,\text{Type}^1_2=2,\text{Type}^1_3=3).
- 工人的初始位置是具有顶点索引的顶点
- 第 3 行:ID=2 的工作人员的描述符。
- 工人的初始位置是具有顶点索引的顶点
13(v^{\text{init}}_2=13). - 该工作人员每单位时间可以执行的最大任务数为
59(L^{\text{max}}_2=59). - 工人可以执行
1工作类型 (N^{\text{JobType}}_2=1),类型3(\text{Type}^2_1=3).
- 工人的初始位置是具有顶点索引的顶点
- 第 4 行:ID=3 的工作人员的描述符。
- 工人的初始位置是具有顶点索引的顶点
10(v^{\text{init}}_3=10). - 该工作人员每单位时间可以执行的最大任务数为
55(L^{\text{max}}_3=55). - 工人可以执行
2工作类型 (N^{\text{JobType}}_3=2),类型2,3(\text{Type}^3_1=2,\text{Type}^3_2=3).
- 工人的初始位置是具有顶点索引的顶点
- 第5行:ID=4的worker的描述符。
- 工人的初始位置是具有顶点索引的顶点
9(v^{\text{init}}_4=9). - 该工作人员每单位时间可以执行的最大任务数为
47(L^{\text{max}}_4=47). - 工人可以执行
3工作类型 (N^{\text{JobType}}_4=3),类型1,2,3(\text{Type}^4_1=1,\text{Type}^4_2=2,\text{Type}^4_3=3).
- 工人的初始位置是具有顶点索引的顶点
- 第 6 行(=1+N_{\text{worker}}): ID=5的worker的描述符。
职位
作业是工作人员在其中一个顶点执行的工作。
- 一份工作:
- 是现实世界中的一个工作单元,例如收获农作物或施用农业化学品。
- 由多个较小的工作任务组成。例如,采摘一块水果、收割指定区域的水稻或在指定区域喷洒化学品。构成工作的这些较小量的工作将被称为“任务”。
- 通过完成构成作业的设定数量的任务来完成作业。
- 实际上,一项工作可能包含多种类型的任务,但在这种情况下,我们只关注任务的数量。因此, 只需处理一定数量的任务即可完成作业.
- 每个作业的作业位置都不同。对于这个问题, 这通过将每个作业定位在 地理数据 图 给出了问题。
- 任务处理及奖励
- 每个作业的任务由 工人.
- 参赛者应为每个工人输出指令 移动 和 执行工作,将它们移动到作业的顶点并执行作业的任务。
- 参赛者将获得奖励 完成作业(处理设定数量的任务).
- 每个工作人员每单位时间可以处理的最大任务数(L^{\text{max}}),因此完成一项工作需要一定的时间。通常,在设定时间的每个时间间隔期间处理设定数量的任务。
- 完成工作时获得的奖励金额将取决于任务处理的时间。更具体地说,它是所有时间间隔的总和(t=1,2,\cdots,T_\text{max}), 的
该时间点处理的每个任务的奖励率的乘积 r(t) \times 该时间点处理的任务数量
- 奖励率, r(t) 用于处理每个时间点的任务 每个工作都不同.
- 所有工人收集的总奖励将作为该问题得分的主要组成部分(评分方法)。参赛者需要决定工人的行动以最大化总奖励。
- 作业之间的依赖关系
- 某些作业依赖于其他作业。也就是说,如果一个作业依赖于另一个作业,则在另一个作业的任务完成之前,无法处理其任务。
- 如果一个作业不依赖于另一个作业,则不存在此类限制。
各种限制
- 输入
- 下一行给出 N_{\text{job}},作业数量。
- 接下来是指示每个作业的组成的行, \text{Job}_i,对于 N_{\text{job}} 工作(N_{\text{job}}\times 3 行)。
的组成 \text{Job}_i 按以下格式给出:
\text{ID}^{\rm{job}}_i\,\,\text{Type}_i\,\,N^{\rm{task}}_i\,\,v^{\rm{job}}_i\\
N^{\rm{reward}}_i\,\, t^{\rm{reward}}_{i,1}\,\, y^{\rm{reward}}_{i,1}\cdots t^{\rm{reward}}_{i,N^{\rm{reward}}_i}\,\, y^{\rm{reward}}_{i,N^{\rm{reward}}_i}\\
N^{\rm{depend}}_i\,\, {\rm{id}}^{\rm{depend}}_{i,1}\,\, \cdots \,\,{\rm{id}}^{\rm{depend}}_{i,N^{\rm{depend}}_i}
- 第 1 行
- 作业 ID: \text{ID}^{\text{job}}_i
- 工作类型: \text{Type}_i
- 要完成的任务数量: N^{\text{task}}_i
- 作业位置(顶点索引): v^{\text{job}}_i
- 第2行(奖励函数的定义, r(t))
- 奖励函数中控制点的数量:N^{\text{reward}}_i
- 控制点列表:t^{\rm{reward}}_{i,1}\,\,y^{\rm{reward}}_{i,1}\,\,t^{\rm{reward}}_{i,2}\,\,y^{\rm{reward}}_{i,2}\,\,\cdots\,\,t^{\rm{reward}}_{i,N^{\text{reward}}_i}\,\,y^{\rm{reward}}_{i,N^{\text{reward}}_i}
- 第 3 行(作业依赖性)
- 作业依赖项数量: N^{\text{depend}}_i
- 依赖作业 ID: {\rm{id}}^{\rm{depend}}_{i,1}\,\,{\rm{id}}^{\rm{depend}}_{i,2}\,\, \cdots \,\,{\rm{id}}^{\rm{depend}}_{i,N^{\rm{depend}}_i}
奖励功能 r(t) 详情
当时每个任务的奖励 t 功能 r(t) 由一个或多个控制点(时间和值对)以及这些点之间的线性插值来定义。
换句话说,给定控制点列表, p=((t_i,y_i))_{i=1,\cdots,n} (t_i,y_i\in \mathbb{Z},t_1 < t_2 < \cdots < t_n,n\geq 1),当时每个任务的奖励 t 功能 r(t) (实际上 r(t;p)),定义为:
r(t)=\begin{cases} y_1, & \text{if}\,\, t < t_1, \\ y_n, & \text{if}\,\, t \geq t_n, \\ (y_\text{next}-y_\text{prev})(t-t_\text{prev})/(t_\text{next}-t_\text{prev})+y_\text{prev}, & \text{otherwise}. \end{cases}
在这里, (t_\text{prev},y_\text{prev}) 是时间最长不超过的对 t,和 (t_\text{next},y_\text{next}) 是时间最小的对 t.
r(t),整数倍 r(t) 及其总和以小数计算。
输入示例
以下是一个示例 N_{\text{job}}=7 (请注意,这是极少数的工作):
7
1 2 625 8
15 1 0 2 1581724 4 1733369 6 1561173 8 1596919 10 1090320 12 1031662 14 929778 16 1095326 18 665006 20 757205 22 567001 24 600233 26 576475 27 0
0
2 3 993 14
15 2 0 3 1147309 5 1186255 7 1098060 9 836498 11 872163 13 1071865 15 1408708 17 2135395 19 1517111 21 1079036 23 740032 25 904947 27 976790 28 0
1 1
3 2 1310 14
15 2 0 3 992842 5 818304 7 676647 9 859283 11 871992 13 859663 15 1776296 17 3025691 19 1304819 21 1606358 23 3469915 25 2801513 27 3046487 28 0
2 2 1
4 2 1356 13
15 3 0 4 2016014 6 2138183 8 1711305 10 2020927 12 2030686 14 1203758 16 973133 18 1102291 20 954221 22 725869 24 700613 26 604824 28 742452 29 0
0
5 1 1225 10
15 5 0 6 1256998 8 1096984 10 820728 12 818626 14 1089776 16 1014615 18 1062766 20 900374 22 1190773 24 1050656 26 1876847 28 1530806 30 952050 31 0
1 4
6 3 1362 7
15 0 0 1 608492 3 960135 5 961858 7 998014 9 1101543 11 1288452 13 1825126 15 1145645 17 1057616 19 1312087 21 991237 23 1123573 25 882743 26 0
2 7 5
7 1 1307 1
15 5 0 6 299791 8 303708 10 533803 12 879014 14 828842 16 946449 18 991630 20 1551550 22 1499622 24 1793967 26 1425447 28 1732069 30 1207139 31 0
0
- 第 1 行:作业总数为
7. (N_{\text{job}}=7)- 给出的实际问题将包括数百个作业。
- 第 2 行:ID=1 的作业描述开始。
- 作业 ID 是
1(\text{ID}^{\text{job}}_1=1). - 作业类型是
2(\text{Type}_1=2). - 完成此作业所需的任务数为
625(N^{\text{task}}_1=625). - 作业位于顶点
8(v^{\text{job}}_1=8).
- 作业 ID 是
- 第3行:ID=1的工作的奖励函数的定义。
- 有
15控制点(N^{\text{reward}}_1=15). - 控制点列表为:((
1,0), (2,1581724), (4,1733369), (6,1561173), (8,1596919), (10,1090320), (12,1031662), (14,929778), (16,1095326), (18,665006), (20,757205), (22,567001), (24,600233), (26,576475), (27,0)).- 可获得奖励的次数为 2,3,\cdots,26.
- 有
- 第4行:ID=1的作业所依赖的作业。这样就完成了 ID=1 的作业的描述。
- 该作业所依赖的作业数量为
0(N^{\text{depend}}_1=0). - (因为它所依赖的作业数量是
0,没有给出作业 ID。)
- 该作业所依赖的作业数量为
- 第 5 行:ID=2 的作业描述开始。
- 作业 ID 是
2(\text{ID}^{\text{job}}_2=2). - 作业类型是
3(\text{Type}_2=3). - 完成此作业所需的任务数为
993(N^{\text{task}}_2=993). - 作业位于顶点
14(v^{\text{job}}_2=14).
- 作业 ID 是
- 第6行:ID=2的工作的奖励函数的定义。
- 有
15控制点(N^{\text{reward}}_2=15). - 控制点列表为:((
2,0), (3,1147309), (5,1186255), (7,1098060), (9,836498), (11,872163), (13,1071865), (15,1408708), (17,2135395), (19,1517111), (21,1079036), (23,740032), (25,904947), (27,976790), (28,0)).- 可获得奖励的次数为 3,4,\cdots,27.
- 有
- 第7行:ID=2的作业所依赖的作业。这样就完成了 ID=2 的作业的描述。
- 该作业所依赖的作业数量为
1(N^{\text{depend}}_2=1). - 该作业取决于 ID= 的作业
1(\text{id}^\text{depend}_{2,1}=1).
- 该作业所依赖的作业数量为
- 第 8 行:ID=3 的作业描述开始。
- 作业 ID 是
3(\text{ID}^{\text{job}}_3=3). - 作业类型是
2(\text{Type}_3=2). - 完成此作业所需的任务数为
1310(N^{\text{task}}_3=1310). - 作业位于顶点
14(v^{\text{job}}_3=14).
- 作业 ID 是
- 第9行:ID=3的工作的奖励函数的定义。
- 有
15控制点(N^{\text{reward}}_3=15). - 控制点列表为:((
2,0), (3,992842), (5,818304), (7,676647), (9,859283), (11,871992), (13,859663), (15,1776296), (17,3025691), (19,1304819), (21,1606358), (23,3469915), (25,2801513), (27,3046487), (28,0)).- 可获得奖励的次数为 3,4,\cdots,27.
- 有
- 第10行:ID=3的作业所依赖的作业。这样就完成了 ID=3 的作业的描述。
- 该作业所依赖的作业数量为
2(N^{\text{depend}}_3=2). - 该作业取决于 ID= 的作业
2,1(\text{id}^\text{depend}_{3,1}=2,\text{id}^\text{depend}_{3,2}=1).
- 该作业所依赖的作业数量为
- 第 11 行:ID=4 的作业描述开始。
- 作业 ID 是
4(\text{ID}^{\text{job}}_4=4). - 作业类型是
2(\text{Type}_4=2). - 完成此作业所需的任务数为
1356(N^{\text{task}}_4=1356). - 作业位于顶点
13(v^{\text{job}}_4=13).
- 作业 ID 是
- 第12行:ID=4的工作的奖励函数的定义。
- 有
15控制点(N^{\text{reward}}_4=15). - 控制点列表为:((
3,0), (4,2016014), (6,2138183), (8,1711305), (10,2020927), (12,2030686), (14,1203758), (16,973133), (18,1102291), (20,954221), (22,725869), (24,700613), (26,604824), (28,742452), (29,0)).- 可获得奖励的次数为 4,5,\cdots,28.
- 有
- 第13行:ID=4的作业所依赖的作业。这样就完成了 ID=4 的作业的描述。
- 该作业所依赖的作业数量为
0(N^{\text{depend}}_4=0). - (因为它所依赖的作业数量是
0,没有给出作业 ID。)
- 该作业所依赖的作业数量为
- 第 14 行:ID=5 的作业描述开始。
- 作业 ID 是
5(\text{ID}^{\text{job}}_5=5). - 作业类型是
1(\text{Type}_5=1). - 完成此作业所需的任务数为
1225(N^{\text{task}}_5=1225). - 作业位于顶点
10(v^{\text{job}}_5=10).
- 作业 ID 是
- 第15行:ID=5的工作的奖励函数的定义。
- 有
15控制点(N^{\text{reward}}_5=15). - 控制点列表为:((
5,0), (6,1256998), (8,1096984), (10,820728), (12,818626), (14,1089776), (16,1014615), (18,1062766), (20,900374), (22,1190773), (24,1050656), (26,1876847), (28,1530806), (30,952050), (31,0)).- 可获得奖励的次数为 6,7,\cdots,30.
- 有
- 第16行:ID=5的作业所依赖的作业。这样就完成了 ID=5 的作业的描述。
- 该作业所依赖的作业数量为
1(N^{\text{depend}}_5=1). - 该作业取决于 ID= 的作业
4(\text{id}^\text{depend}_{5,1}=4).
- 该作业所依赖的作业数量为
- 第 17 行:ID=6 的作业描述开始。
- 作业 ID 是
6(\text{ID}^{\text{job}}_6=6). - 作业类型是
3(\text{Type}_6=3). - 完成此作业所需的任务数为
1362(N^{\text{task}}_6=1362). - 作业位于顶点
7(v^{\text{job}}_6=7).
- 作业 ID 是
- 第18行:ID=6作业的奖励函数定义。
- 有
15控制点(N^{\text{reward}}_6=15). - 控制点列表为:((
0,0), (1,608492), (3,960135), (5,961858), (7,998014), (9,1101543), (11,1288452), (13,1825126), (15,1145645), (17,1057616), (19,1312087), (21,991237), (23,1123573), (25,882743), (26,0)).- 可获得奖励的次数为 1,2,\cdots,25.
- 有
- 第19行:ID=6的作业所依赖的作业。这样就完成了 ID=6 的作业的描述。
- 该作业所依赖的作业数量为
2(N^{\text{depend}}_6=2). - 该作业取决于 ID= 的作业
7,5(\text{id}^\text{depend}_{6,1}=7,\text{id}^\text{depend}_{6,2}=5).
- 该作业所依赖的作业数量为
- 第 20 行:ID=7 的作业描述开始。
- 作业 ID 是
7(\text{ID}^{\text{job}}_7=7). - 作业类型是
1(\text{Type}_7=1). - 完成此作业所需的任务数为
1307(N^{\text{task}}_7=1307). - 作业位于顶点
1(v^{\text{job}}_7=1).
- 作业 ID 是
- 第21行:ID=7的工作的奖励函数的定义。
- 有
15控制点(N^{\text{reward}}_7=15). - 控制点列表为:((
5,0), (6,299791), (8,303708), (10,533803), (12,879014), (14,828842), (16,946449), (18,991630), (20,1551550), (22,1499622), (24,1793967), (26,1425447), (28,1732069), (30,1207139), (31,0)).- 可获得奖励的次数为 6,7,\cdots,30.
- 有
- 第 22 行(=1+3\times N_{\text{job}}):ID=7 的作业所依赖的作业。这样就完成了 ID=7 的作业的描述。
- 该作业所依赖的作业数量为
0(N^{\text{depend}}_7=0). - (因为它所依赖的作业数量是
0,没有给出作业 ID。)
- 该作业所依赖的作业数量为
完整输入 1 示例
300
14 19
1 7 1
1 2 1
2 9 1
2 3 1
3 5 1
3 7 1
3 6 1
4 13 2
4 10 2
4 6 1
4 5 1
6 8 1
7 8 1
8 14 2
9 11 2
10 12 2
10 11 2
12 13 2
13 14 2
5
6 100 3 1 2 3
13 59 1 3
10 55 2 2 3
9 47 3 1 2 3
9 89 1 2
7
1 2 625 8
15 1 0 2 1581724 4 1733369 6 1561173 8 1596919 10 1090320 12 1031662 14 929778 16 1095326 18 665006 20 757205 22 567001 24 600233 26 576475 27 0
0
2 3 993 14
15 2 0 3 1147309 5 1186255 7 1098060 9 836498 11 872163 13 1071865 15 1408708 17 2135395 19 1517111 21 1079036 23 740032 25 904947 27 976790 28 0
1 1
3 2 1310 14
15 2 0 3 992842 5 818304 7 676647 9 859283 11 871992 13 859663 15 1776296 17 3025691 19 1304819 21 1606358 23 3469915 25 2801513 27 3046487 28 0
2 2 1
4 2 1356 13
15 3 0 4 2016014 6 2138183 8 1711305 10 2020927 12 2030686 14 1203758 16 973133 18 1102291 20 954221 22 725869 24 700613 26 604824 28 742452 29 0
0
5 1 1225 10
15 5 0 6 1256998 8 1096984 10 820728 12 818626 14 1089776 16 1014615 18 1062766 20 900374 22 1190773 24 1050656 26 1876847 28 1530806 30 952050 31 0
1 4
6 3 1362 7
15 0 0 1 608492 3 960135 5 961858 7 998014 9 1101543 11 1288452 13 1825126 15 1145645 17 1057616 19 1312087 21 991237 23 1123573 25 882743 26 0
2 7 5
7 1 1307 1
15 5 0 6 299791 8 303708 10 533803 12 879014 14 828842 16 946449 18 991630 20 1551550 22 1499622 24 1793967 26 1425447 28 1732069 30 1207139 31 0
0
输出 1
给定上述数据,参赛者必须按照以下格式在每个时间间隔内为所有工人提供输出。
\text{Actions}_1\\
\vdots\\
\text{Actions}_{T_\text{max}}
(在最后一行后插入换行符)
在这里, \text{Actions}_i 代表此时所有工人的操作 i,并且表示如下,假设 \text{action}^i_j 代表工人的动作 j 时间 i.
\text{action}^i_1\\
\text{action}^i_2\\
\vdots\\
\text{action}^i_{N_{\text{worker}}}
工人行动
stay:既不移动也不执行工作,停留在当前位置。move w:移动距离 1 沿着从当前位置到顶点索引对应的顶点的最短路径w。如果不满足以下约束,将会导致WA(错误答案)。- 顶点索引对应的顶点
w必须存在。 - 当前位置不能是顶点
w.
- 顶点索引对应的顶点
execute i a:执行 ID= 的作业的任务i,a次。如果不满足以下约束,将会导致WA(错误答案)。- 工人当前位置必须与 ID= 的作业位置相同
i. - ID= 的作业类型
i必须包含在工作人员可以执行的工作类型中。 a必须是大于或等于 1 的整数。a不得超过 ID= 的作业的剩余任务量i.a不得超过 L^\text{max}_i,工作人员可以执行的任务数量的上限。- ID= 的作业所在的作业
i取决于必须已完成。 - 奖励值必须为正数。
- 工人当前位置必须与 ID= 的作业位置相同
对于 move w,如果当前位置和顶点之间有 2 个或更多不同的最短路径 w,没有指定如何选择。在这种情况下,参赛者可以通过重复选择并移动到路径上的点来选择所需的路径。
指定 \text{action} 与上述任何模式都不匹配的字符串将导致 WA(错误答案)。
另外,如果存在一些作业,其处理的总任务量超过其要完成的任务数 N^{\text{task}}_i,这将导致 WA or RE.
- 输出
- 对于以下内容 N_\text{worker}\times T_\text{max} 行,输出动作, \text{action}^i_j,对于每个工人,其中 1 \leq i \leq T_\text{max} 和 1 \leq j \leq N_\text{worker}.
输出示例
以下是一个示例 T_\text{max}=30,N_\text{worker}=5:
move 8
stay
move 13
stay
stay
execute 1 100
stay
move 13
stay
stay
execute 1 100
stay
move 13
move 1
stay
execute 1 100
stay
move 13
move 1
stay
execute 1 100
stay
move 13
move 1
stay
execute 1 100
stay
move 13
execute 7 47
stay
execute 1 100
stay
execute 4 55
execute 7 47
stay
execute 1 25
move 14
execute 4 55
execute 7 47
stay
stay
move 14
execute 4 55
execute 7 47
stay
stay
move 14
execute 4 55
execute 7 47
stay
stay
move 14
execute 4 55
execute 7 47
stay
stay
move 14
execute 4 55
execute 7 47
stay
stay
move 14
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
execute 2 59
execute 4 55
execute 7 47
stay
stay
stay
execute 4 55
execute 7 47
stay
stay
stay
stay
execute 7 47
stay
stay
stay
stay
execute 7 47
stay
- 第 1-5 行:指定所有工作人员同时执行的操作 1.
- 第 1 行:该工作人员 (ID=1) 从当前位置向顶点移动
8. - 第 2 行:该工人 (ID=2) 留在原处,不执行工作或移动。
- 第 3 行:该工作人员 (ID=3) 从当前位置向顶点移动
13. - 第 4 行:该工人 (ID=4) 留在原处,不执行工作或移动。
- 第 5 行:该工人 (ID=5) 留在原处,不执行工作或移动。
- 第 1 行:该工作人员 (ID=1) 从当前位置向顶点移动
- 第 6-10 行:指定所有工作人员同时执行的操作 2.
- 第 6 行:该工作人员 (ID=1) 执行 ID= 的作业的任务
1在其当前位置100次。 - 第 7 行:该工人 (ID=2) 留在原处,不执行工作或移动。
- 第 8 行:该工作人员 (ID=3) 从当前位置向顶点移动
13. - 第 9 行:该工人 (ID=4) 留在原处,不执行工作或移动。
- 第 10 行:该工人 (ID=5) 留在原处,不执行工作或移动。
- 第 6 行:该工作人员 (ID=1) 执行 ID= 的作业的任务
- 省略第 11-145 行。
- 第146-150行:指定所有工人在某个时间的操作 30.
- 第 146 行:该工人 (ID=1) 留在原处,不执行工作或移动。
- 第 147 行:该工人 (ID=2) 留在原地而不执行工作或移动。
- 第 148 行:该工人 (ID=3) 留在原处,不执行工作或移动。
- 第 149 行:该工作人员 (ID=4) 执行 ID= 的作业的任务
7在其当前位置47次。 - 第 150 行:该工人 (ID=5) 留在原处,不执行工作或移动。
输入 2(评分)
If 输出 1 有效,输入分数 S 在标准输入上以以下格式给出。
S
如果参赛者没有从标准输入读取该值,可能会导致 TLE.
详细排名方法请参见 排名方法
评分方法
分数, S 由下式确定。
\begin{aligned} S=\left\lfloor\sum_{j\in J_\text{finished}}\sum_{w \in W}\sum_{t=1}^{T_\text{max}}a^w_j(t)r_j(t)\right\rfloor \end{aligned}
- 已完成作业集:J_\text{finished}
- 所有工人的集合:W
- 作业数量 j 工作人员执行的任务 w 时间 t:a^w_j(t)
- 工作的每项任务奖励 j 时间 t:r_j(t)
请注意 \left\lfloor x \right\rfloor 表示floor函数,返回小于等于的最大整数 x.
测试用例生成规则
地理数据(图表)
-
术语
- 在这里,我们使用术语 分区 用于划分矩形区域的操作, [x_0,x_1]\times[y_0,y_1]\,\,(x_0<x_1,y_0<y_1),垂直和水平各半,分成四个较小的矩形。
- 具体来说,操作划分区域 [x_0,x_1]\times[y_0,y_1] 分为以下四块。
- [x_0,(x_1+x_0)/2]\times[y_0,(y_0+y_1)/2]
- [x_0,(x_1+x_0)/2]\times[(y_0+y_1)/2,y_1]
- [(x_1+x_0)/2,x_1]\times[y_0,(y_0+y_1)/2]
- [(x_1+x_0)/2,x_1]\times[(y_0+y_1)/2,y_1]
- 我们还定义了一个函数, \text{Split}(R),执行此操作(从接收到的矩形区域给出上述区域集)。
-
参数
- 矩形区域大小:L>0
- 最大分区深度:d_\text{max} \in \mathbb{Z}_{\geq 0}
- (最大)矩形数量:M(整数 0 或更大, (4^{d_\text{max}+1}-1)/3 或更少)
- 距离最小刻度:s>0
- 切割面积比例:C\in (0,1]
-
生成程序1 (生成图表)
- 准备一组矩形区域, U=\{\}.
- 添加矩形区域 R=[0,L]\times[0,L] to U.
- If d_\text{max}=0,继续
8. - 从中选择一个矩形 U 随机并调用该矩形 r.
- 如果面积 r is L^2/4^{d_\text{max}},返回
4. - 添加所有元素 \text{Split}(R) to U.
- 如果这些元素已经在 即使添加 U, U 也不会改变。
- If |U| > M满意,继续
8.如果没有,返回4. - 创建一个加权、无向图, G=(V,E),W:E\rightarrow \mathbb{R}_{> 0},来自集合 A,中所有矩形的边的并集 U.
- 套装 图中顶点的 V 由集合中线段相交的所有点组成 A,所有边的并集。
- 边集 图中的 E 由所有顶点对组成 \{a,b\},其中 a\neq b 并且可以达到 b 来自 a 现场 A,所有边的并集,不经过任何其他顶点。
- 重量 W 是从点之间的欧几里得距离导出的。
- 这张图, G=(V,E) (带重量 W),用于生成地理数据。
(参考:Eisenstat, D.,随机道路网络:四叉树模型,第八届分析算法和组合学研讨会论文集 (ANALCO),第 76-84 页,2011 年(DOI:https://doi.org/10.1137/1.9781611973013.9))
- 生成程序2 (生成高程)
- 准备一个正方形区域, R=[0,1024]\times[0,1024].
- 除法 R by 128 两者 x 和 y 方向(创建 128\times128 方形区域大小 8\times8).
- 随机选择 20 这些方形区域来自 R 并调用它们的并集 A.
- 再次随机选择 20 这些方形区域来自 R 并调用它们的并集 B.
- 求解通过上述除法运算离散化的以下偏微分方程
2到时间 t=100000 (换句话说,计算 u(100000,x,y)):\displaystyle \frac{\partial u}{\partial t}=\Delta u-b(x,y)u+a(x,y)
时刻的初始值 t=0 is u(0,x,y)=u_0(x,y)\equiv 0,我们使用诺伊曼边界条件。 a(x,y) 和 b(x,y) 定义如下:
a(x,y)=\begin{cases} 1/8^2, & \text{if}\ (x,y) \in A, \\ 0, & \text{otherwise}, \end{cases}
b(x,y)=\begin{cases} 1/8^2, & \text{if}\ (x,y) \in B, \\ 0, & \text{otherwise}. \end{cases} - 标准化 u(100000,x,y) 到范围 [0,1],并将其用作高程, e(x,y).
-
生成程序3(剪切图形,距离缩放)
-
匹配高程数据 e(x,y) 在程序2中生成到图空间的大小, [0,L]\times[0,L]。 换句话说,定义空间尺度的高程 \tilde e(x,y),如 \tilde e(x,y)= e(L\times x/1024,L\times y/1024).
-
对于功能 H(z)=\{(x,y) \in [0,L]\times[0,L]|\tilde e(x,y)>z\},返回其中的部分 \tilde e(x,y) 大于实际值 z,调用最大值 z 的面积 H(z) is C\times L^2 或更大, h.
- 对于图形边集 E 在生成过程1中生成,删除所有边 E 两端的两个顶点都在下面 h.
- 让图表 G'=(V',E') 是图的最大连通分量 G=(V,E).
- 定义权重 W':E' \rightarrow \mathbb{R}_{> 0}: 如下:W'(e)= s\times W(e)/\min_{e' \in E'}W(e')
- 使用图表 G'=(V',E') (带重量 W')作为地理数据。
-
代表奖励的分段线性函数
对于这个问题,表示每次奖励的函数(更准确地说,每个任务的奖励值)是使用有限数量的点之间的线性插值来表达的。我们将这些点称为控制点,生成有限数量的控制点的规则如下。
- 参数
- 正奖励部分的长度:L\geq 1
- 划分区间的长度:l\geq 1
- 奖励标准值:s > 0
- 生成控制点值时使用的标准偏差:\sigma' > 0
- 奖励上限:M > 0
- 奖励下限:m > 0
~
- 设奖励开始时间为 b=\text{randint}(1,T_\text{max}-L),奖励结束时间为 e=b+L,段数为 d=\text{round}(L/l)。在这里, \text{randint}(m,n) 是统一选择 m 到 n 之间的随机整数的函数,并且 \text{round}(x) 是一个返回值的函数 x 四舍五入到最接近的整数。
- 生成 d+1 遵循对数正态分布的独立随机值 \mu=0 和 \sigma=\sigma',让他们成为 \{c_i\}_{i=1}^{d+1}.
- 定义 \{v_i\}_{i=1}^{d+1} by v_i=\prod_{j=1}^{i}c_j.
- 让 B=s\sqrt{(d+1)/\sum_{i=1}^{d+1}v_i^2},并定义 \{r_i\}_{i=1}^{d+1} by r_i=\text{round}(Bv_i).
- 如果存在 i 这样 r_i > M or r_i < m,返回
2. - 让 t_i=\text{round}(b+(i-1)L/d),并使用时间和奖励值对列表 ((b-1,0),(t_1,r_1),(t_2,r_2),\cdots,(t_{d+1},r_{d+1}),(e+1,0)) 作为控制点列表。
如果没有另外指定,则使用均匀随机分布。
排名方法
临时测试
对于临时测试, 50 测试用例是从用于系统测试的测试用例中随机选择并执行的。然而,对于一种参数模式仅选择一种测试用例。
评估方法与系统测试相同。请参阅下面的系统测试部分。
系统测试
对于系统测试,给出以下一些特征参数以满足备注栏中列出的属性:
| 因素 | 对应参数 | 类型数量 | 备注 |
|---|---|---|---|
| 工作时间长度 | T_\text{max} | 3 | 短(300),中(700), 长(1000) |
| 空间(地理数据)大小 测试用例生成规则中的 | d_\text{max} 在测试用例生成规则中 地理数据 | 3 | 小(5),中(6),大(7) |
| 工人数量 | N_{\text{worker}} | 4 | 单(1), 几个(2),中等(5), 许多(10) |
| 所有作业数 | N_{\text{job}} | 3 | 几个(250 \leq N_{\text{job}} \leq 253 ),中等(500 \leq N_{\text{job}} \leq 503), 许多(1000 \leq N_{\text{job}} \leq 1003) |
| 共有:108 个图案 | 为每个模式生成 40 个测试用例 |
对于其中的每个模式, 40 生成具有不同种子值的测试用例,总共 3 \times 3 \times4\times 3 \times 40 = 4320 测试用例。
这只是上表中参数的模式生成。除了这个过程之外,还会为每个测试用例生成地理信息、工作等数据。
采用相对评价体系进行排名。对于每个测试用例,我们计算相对分数 \text{round}(10^{9} \times \frac{\text{YOUR\_SCORE}}{\text{MAX\_SCORE}}),其中 \text{YOUR\_SCORE} 是你的 分数 和 \text{MAX\_SCORE} 是所有参赛者在该测试用例中获得的最高分。提交的分数是相对分数的总和。
如果您的提交产生无效输出或超出某些测试用例的时间限制,则只有这些测试用例的分数将为零。
系统测试将仅执行 上次提交收到的结果不是 CE。最后提交时请注意不要出错。
关于相关评价体系
在临时/系统测试中,排名将仅使用收到除以下结果之外的最后提交的结果来计算: CE 。在计算相对分数时,仅使用最后提交的内容来计算每个测试用例的所有参赛者中的最高分数。
排名中显示的分数是相对的,每当有新的提交到达时,所有相对分数都会重新计算。另一方面,提交页面上显示的每个提交的分数是通过将每个测试用例的分数相加而获得的绝对分数,并且不显示相对分数。为了了解当前排名中除最新提交之外的提交的相对分数,您需要重新提交。如果您提交的测试用例产生无效输出或超出时间限制,则提交页面中显示的绝对分数将变为 0,但排名显示正确回答的测试用例的相对分数总和。
约束
- 字符编码为 UTF-8(尽管仅使用 ASCII 字符)。
- 行尾代码是
LF(0x0A). - 分隔符是半角空格 (
0x20) - 允许使用尾随分隔符。
对于十进制值, [十进制] 附加 。
输入 1
- 300 \leq T_\text{max} \leq 1000 和 T_\text{max} 是的倍数 100
- 150\leq N_V\leq 2000
- 4N_V/3\leq N_E\leq 2 N_V
- 1\leq u_i,v_i\leq N_V, u_i \neq v_i (1 \leq i \leq N_E)
- 1\leq d_i \leq 128 (1 \leq i \leq N_E)
- 给出的图保证是连通的并且不包含自环或多边。
- 1 \leq N_\text{worker} \leq 10
- 1\leq v^\text{init}_i \leq N_V (1 \leq i \leq N_\text{worker})
- 30\leq L^\text{max}_i\leq 100 (1 \leq i \leq N_\text{worker})
- 1 \leq N^\text{JobType}_i \leq 3 (1 \leq i \leq N_\text{worker})
- 1\leq \text{Type}^i_j\leq 3 (1 \leq i \leq N_\text{worker},1 \leq j \leq N^\text{JobType}_i)
- 250 \leq N_\text{job} \leq 1003
- \text{ID}^\text{job}_i=i (1 \leq i \leq N_\text{job})
- 1\leq \text{Type}_i\leq 3 和 \text{Type}_i 包含在可处理的作业类型中 1 或更多工人。 (1 \leq i \leq N_\text{job})
- 500 \leq N^\text{task}_i \leq 1500(1 \leq i \leq N_\text{job})
- 1 \leq v^\text{job}_i \leq N_V (1 \leq i \leq N_\text{job})
- 1 \leq N^\text{reward}_i \leq 43 (1 \leq i \leq N_\text{job})
- 0\leq t^\text{reward}_{i,1}<t^\text{reward}_{i,2}<\cdots<t^\text{reward}_{i,N^\text{reward}_i}\leq T_\text{max}+1(1 \leq i \leq N_\text{job})
- y^\text{reward}_{i,1}=y^\text{reward}_{i,N^\text{reward}_i}=0,1 \leq y^\text{reward}_{i,j} \leq 10^7 (1 \leq i \leq N_\text{job},2 \leq j \leq N^\text{reward}_i-1)
- 0\leq N^\text{depend}_i\leq 3(1 \leq i \leq N_\text{job})
- 1 \leq \text{id}^\text{depend}_{i,j} \leq N_\text{job},\text{id}^\text{depend}_{i,j} \neq \text{id}^\text{depend}_{i,k},\text{id}^\text{depend}_{i,j}\neq i (1 \leq i \leq N_\text{job},1\leq j \leq N^\text{depend}_i,1\leq k\leq N^\text{depend}_i,j\neq k)
- 作业依赖关系可以看作是一个有向无环图(不一定是连通的),每个作业作为顶点,作业之间的依赖关系作为有向边,每个连通分量的大小为 4 或更少。
输入 2(评分)
- 0 \leq S \leq 2^{63}-1
地理数据
- L=2048
- d_\text{max}\in\{5,6,7\}
- s=1
- 0.3 \leq C < 0.4 [十进制] 附加
- M=\text{round}(0.45(4^{d_\text{max}+1}-1)/(3\times 2^{d_\text{max}-5}))
分段线性奖励函数
- 100 \leq L \leq T_\text{max}
- l = 25
- 10^6 \leq s \leq 2\times 10^6
- 0.3 \leq \sigma' < 0.38 [十进制] 附加
- M = 10^7
- m = 1
工具包
可以从以下位置下载解决此问题的工具包 这里。它包括以下内容:
- 评判程序(A、B均适用)
- 测试用例生成器(A 和 B)
- 示例代码(在 C++ 中,问题 A 和 B 各一个)
- 展示台
展示台
工具包中的判断程序生成的日志文件(JSON 格式)可用于可视化结果。
可视化工具包含在工具包中,但也可用 这里 。
有关详细信息,请阅读工具包中的 README 以及可视化工具页面底部的说明。