故事
高桥决定玩一款多人竞争的夺地游戏。 与人工智能对手争夺土地的控制权,并力求以尽可能大的优势获胜。
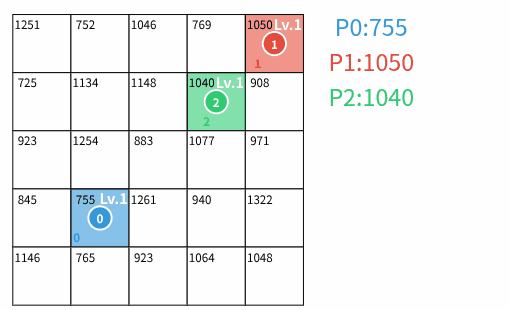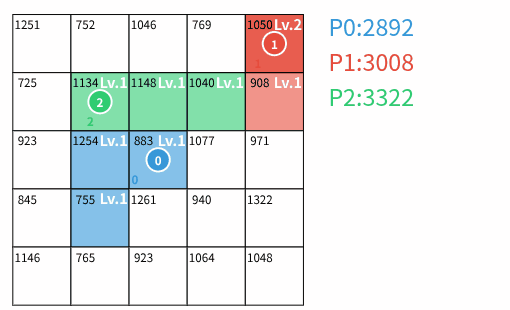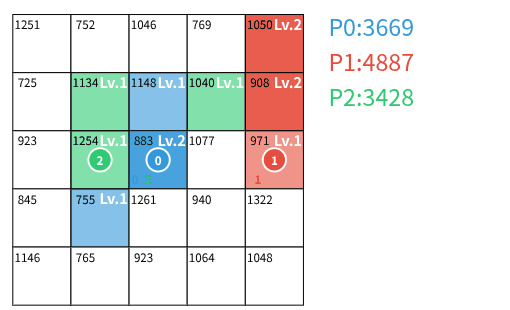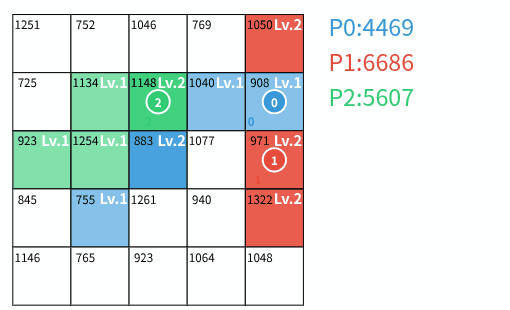
问题陈述
有一块土地由 N\times N 网格。 让 (0, 0) 是左上角单元格的坐标,并且 (i, j) 是所在单元格的坐标 i 细胞下降并且 从那里右侧的 j 单元格。
在这片土地上, M 玩家正在玩一场夺地游戏。 球员编号从 0 to M-1。 另一个 M-1 除了高桥(玩家 0)由AI控制。
每位玩家 p 最初拥有一个单元格 (sx_p,sy_p) 作为他们的 初始领土,并放置一个 片 该单元格上的 。
每个单元格 (i,j) 有一个 值 数组$$$b$$$的 V_{i,j} 和 级别 L_{i,j}。 该值在整个游戏过程中不会改变,而等级会随着游戏的进行而改变。 初始状态下,每个玩家的初始领地等级为 1,不属于任何玩家的单元格等级为 0.
游戏包括 T 转。每个回合都按照以下步骤进行。
- 移动目的地的决定: 所有玩家同时决定其棋子的目的地。目的地必须满足以下条件。
- 定义 可到达区域 作为从玩家棋子的当前位置通过遍历属于玩家的相邻(上、下、左、右)单元格可以到达的单元格集合。目的地必须包含在可到达区域内或者与可到达区域中的至少一个小区相邻。
- 目的地不得包含其他玩家的棋子。
- 冲突解决: 同时移动所有棋子后,以下过程将应用于包含两个或多个棋子的每个单元格。
- 如果单元格包含该单元格所有者的棋子,则只有该棋子保留在棋盘上,并且该单元格上的所有其他棋子都会被移除。
- 如果该单元格不属于任何玩家,或者它不包含该单元格所有者的棋子,则该单元格上的所有棋子都会被移除。
- 领土更新: 对于每个未移除的玩家棋子,根据目标单元格的情况应用以下过程。
- 职业: 如果该单元格不属于任何玩家,则它成为该玩家的领地,其等级变为 1.
- 加固: 如果该单元格已经是玩家的领土,则将其等级提高 1。然而,最大水平是恒定的 U 在输入中给出;如果级别已经是 U,它不会改变。
- 攻击: 如果该单元格属于其他玩家,则将其等级降低 1。如果水平变为 0 结果,该单元格成为攻击玩家的领土,其等级变为 1。如果水平没有变成 0,攻击玩家的棋子被移除。
- 碎片修复: 本回合中移除的所有棋子都会返回到本回合开始时(移动之前)它们所在的单元格。
请注意,玩家的棋子始终存在于自己的领土上,并且包含棋子的单元格不会受到其他玩家的攻击。因此,玩家的领地永远不会空着。
之后 T 回合,得分 每个玩家的 S_p 每个玩家的 p 定义为 V_{i,j} \times L_{i,j} 所有单元格 (i,j) 属于玩家 p (包括无法到达的地区)。
高桥的目标是 最大化他的得分与得分最高的AI玩家的比率。 也就是说,让 S_0 是高桥(玩家 0),并让 S_A 是得分最高的 AI 玩家的得分。 你的任务是选择玩家的行动 0 每回合最大化 S_0 / S_A.
人工智能行动政策
每个AI玩家 p (1\leq p\leq M-1) 有内部参数 wa_p, wb_p, wc_p, wd_p,和 \varepsilon_p,并根据以下算法确定其移动目的地。
对于每个单元格 (i,j),定义评估值 A_{p,i,j} 供玩家使用 p 如下。
- 如果单元格不属于任何玩家: A_{p,i,j}=V_{i,j}\times wa_p
- 如果该单元格属于玩家 p 且其级别小于 U: A_{p,i,j}=V_{i,j}\times wb_p
- 如果该单元格属于玩家 p 其级别为 U: A_{p,i,j}=0
- 如果该单元格属于另一个玩家并且其等级为 1: A_{p,i,j}=V_{i,j}\times wc_p
- 如果该单元格属于另一个玩家并且其等级至少为 2: A_{p,i,j}=V_{i,j}\times wd_p
让 B_p 是玩家所在的所有单元格的集合 p 可以移动。玩家的移动目的地 p 确定如下。
- 有概率 \varepsilon_p,执行 随机动作.
- 均匀地随机选择一个单元格 B_p.
- 有概率 1-\varepsilon_p,执行 贪婪行动.
- 选择一个单元格 B_p 最大化 A_{p,i,j}。如果存在多个这样的小区,则从其中统一随机选择一个。
评分
让 S_0 是高桥(玩家 0),并让 S_A=\max_{1 \leq p \leq M-1} S_p 成为AI玩家中的最高分。 测试用例的绝对分数定义为 \[ \mathrm{round}\left(10^5 \times \log_2\left(1+\frac{S_0}{S_A}\right)\right)。 \] 绝对分数越高越好。
对于每个测试用例,我们计算 相对分数 \mathrm{round}(10^9\times \frac{\mathrm{YOUR}}{\mathrm{MAX}}),其中 YOUR 是您的绝对分数,MAX 是在该测试用例中获得的所有竞争对手中最高的绝对分数。提交的分数是相对分数的总和。
最终排名将通过比赛结束后进行的系统测试进行更多的输入来确定。 在临时/系统测试中,如果您提交的测试用例产生非法输出或超出了某些测试用例的时间限制,则只有这些测试用例的分数为零,并且您的提交将被排除在这些测试用例的 MAX 计算之外。
系统测试将仅执行 上次提交收到的结果不是 CE 。 最后提交时请注意不要出错。
测试用例数量
- 临时测试:100
- 系统测试:3000。我们将发布 种子.txt (sha256=24432b101519407fc0e5c2f92f3b939089115b79fd2e71ab3ee737ebc53e0601) 比赛结束后。
关于相关评价体系
在临时/系统测试中,排名将仅使用收到除以下结果之外的最后提交的结果来计算: CE。 在计算相对分数时,仅使用最后提交的内容来计算每个测试用例的 MAX。
排名中显示的分数是相对的,每当有新的提交到达时,所有相对分数都会重新计算。 另一方面,提交页面上显示的每个提交的分数是每个测试用例的绝对分数的总和,并且不显示相对分数。 为了了解当前排名中除最新提交之外的提交的相对分数,您需要重新提交。 如果您提交的测试用例产生非法输出或超出时间限制,则提交页面上显示的分数将为 0,但排名显示的是正确回答的测试用例的相对分数总和。
关于执行时间
每次运行的执行时间可能略有不同。 此外,由于系统测试同时执行大量执行,因此观察到与临时测试相比,执行时间增加了几个百分点。 由于这些原因,非常接近期限的提交可能会导致 TLE 在系统测试中。 请测量程序中的执行时间以终止进程,或者在执行时间上留有足够的余量。
输入和输出
一、板子尺寸 N, 玩家数量 M,圈数 T,等级上限 U,值 每个单元格的 V_{i,j} 每个细胞的 (i,j),以及初始领土 (sx_p,sy_p) 每个玩家的 p 由标准输入以以下格式给出。
N M T U
V_{0,0} \cdots V_{0,N-1}
\vdots
V_{N-1,0} \cdots V_{N-1,N-1}
sx_0 sy_0
\vdots
sx_{M-1} sy_{M-1}
每个值都满足以下约束。
- N = 10
- 2\leq M\leq 8
- T = 100
- 1\leq U\leq 5
- 1\leq V_{i,j}
- \displaystyle\sum_{i,j}V_{i,j}=1000\times N^2
- 0\leq sx_p,sy_p\leq N-1
- 初始领土 所有玩家的 (sx_p,sy_p) 所有玩家中 p 成对不同。
读取上述信息后,每回合重复以下输入/输出 t (1\leq t\leq T).
每回合输出目的地 玩家的 (tx_0,ty_0) 玩家的 0的一行内容按以下格式输出到标准输出。目的地必须满足问题陈述中描述的条件。
tx_0 ty_0
输出后面必须跟有新行,并且您必须刷新标准输出。 否则,提交内容可能会被判定为 在输出以下内容之前,不会给出 TLE.
然后,作为回合结束时的棋盘信息 t,单元格 (tx_p,ty_p) 由每位玩家选择 p 作为移动目的地,位置 (ex_p,ey_p) 每个玩家的 p回合结束时的棋子,且拥有者 O_{i,j} 和级别 回合结束时的 L_{i,j} 每个细胞的 (i,j) 由标准输入以以下格式给出。
tx_0 ty_0
\vdots
tx_{M-1} ty_{M-1}
ex_0 ey_0
\vdots
ex_{M-1} ey_{M-1}
O_{0,0} \cdots O_{0,N-1}
\vdots
O_{N-1,0} \cdots O_{N-1,N-1}
L_{0,0} \cdots L_{0,N-1}
\vdots
L_{N-1,0} \cdots L_{N-1,N-1}
每个值都满足以下约束。
- 0\leq tx_p,ty_p\leq N-1
- 0\leq ex_p,ey_p\leq N-1
- -1\leq O_{i,j}\leq M-1
- If O_{i,j}=-1,该单元格不属于任何玩家。
- 0\leq L_{i,j}\leq U
示例
| 转 | 输出 | 输入 |
|---|---|---|
| 初始输入 | 10 3 100 2 990 1001 985 ... ... 3 4 7 2 5 8 |
|
| 1 | 3 5 |
3 5 7 3 5 7 3 5 7 3 5 7 -1 -1 -1 ... ... 0 0 0 ... ... |
| \vdots | ||
| 100 | 4 6 |
4 6 6 1 4 9 4 6 6 1 4 9 0 0 -1 ... ... 2 1 0 ... ... |
输入生成
让 \mathrm{randint}(L,U) 表示一个函数,该函数在 L 和 U (含)。 让 \mathrm{randdouble}(L,U) 表示在范围内均匀随机生成实值的函数 [L,U).
- 玩家数量 M 是由生成的 \mathrm{randint}(2,8).
- 等级上限 U 是由生成的 \mathrm{randint}(1,5).
- 初始位置 (sx_p,sy_p) 的球员是随机均匀生成的,因此两个位置不会重叠。
的一代 V
V_{i,j} 通过以下过程生成。
- 让 a=\mathrm{randdouble}(0.0,3.0).
- 对于每个单元格 (i,j),初始化 V_{i,j}=(\mathrm{randdouble}(0.5,1.0))^a.
- 让 K=\mathrm{randint}(0,2),并重复以下过程 K 次。
- 让 x=\mathrm{randint}(0,N-1), y=\mathrm{randint}(0,N-1), b=\mathrm{randdouble}(1.0,4.0), m=\mathrm{randint}(0,4),和 R=\mathrm{randdouble}(1.0,5.0).
- 取决于值 m,将以下内容添加到每个单元格 (i,j).
- m=0 : V_{i,j}=V_{i,j}+b\times\exp\left(-\frac{(i-x)^2+(j-y)^2}{2R^2}\right)
- m=1 : V_{i,j}=V_{i,j}+\frac{b}{1+\sqrt{(i-x)^2+(j-y)^2}/R}
- m=2 :对于满足条件的单元格 (i-x)^2+(j-y)^2\leq R^2,设置 V_{i,j}=V_{i,j}+b/4
- m=3 : V_{i,j}=V_{i,j}+\frac{b}{1+(|i-x|+|j-y|)/R}
- m=4 :对于满足条件的单元格 |i-x|+|j-y|\leq R,设置 V_{i,j}=V_{i,j}+b/4
- 让 S 是所有的总和 V_{i,j},并设置 V_{i,j}=\left\lceil \frac{V_{i,j}\times 1000\times N^2}{S}\right\rceil.
- 虽然 \displaystyle\sum_{i,j}V_{i,j}>1000\times N^2,在具有以下条件的单元格中重复随机均匀地选择一个单元格 V_{i,j}\geq 2 并减少 V_{i,j} by 1.
AI内部参数的生成
对于每个 AI 玩家 p (1\leq p\leq M-1),
- wa_p,wb_p,wc_p,wd_p 独立生成 \mathrm{randdouble}(0.3,1.0).
- \varepsilon_p 是由生成的 \mathrm{randdouble}(0.1,0.5).
工具(输入生成器和可视化工具)
- 网页版:这比提供动画和手动播放的本地版本更强大。
- 本地版本: 你需要一个编译环境 Rust 语言.
- Windows 预编译二进制文件:如果你不熟悉Rust语言环境,请使用这个。
比赛期间,您可以在 X 上分享所提供的可视化工具的输出图像 (PNG),用于 X 上的 seed=0。 您必须使用指定的标签和公共帐户。您只能共享seed=0 的可视化结果和分数。请勿分享视频、输出本身、其他种子的分数或提及解决方案或讨论。
该工具使用的输入文件格式
提供给本地测试器的输入文件具有附加到提供给解决方案程序的初始输入末尾的附加信息,格式如下。该信息仅在判断内部使用,不会提供给解决方案程序。
初始输入后,每个AI玩家的内部参数 p (1\leq p\leq M-1) 给出 M-1 行采用以下格式。
wa_p wb_p wc_p wd_p \varepsilon_p
然后,在 T\times(M-1) 行,两个独立的均匀随机数 r_{1,t,p} 和 r_{2,t,p} 在范围内 [0,1),用于每个AI玩家的动作选择 每回合 p (1\leq p\leq M-1) 每回合 t (1\leq t\leq T),按以下格式给出。 在这里, r_{1,t,p} 用于决定是采取随机动作还是贪婪动作,并且 r_{2,t,p} 用于选择移动目的地。
r_{1,t,p} r_{2,t,p}
示例解决方案
详细信息
Python 示例解决方案如下所示。 在此程序中,在每个回合中,玩家要选择的单元格集 使用BFS计算 0 可移动,并从其中统一随机选择一个目的地。
from collections import deque
import random

random.seed(0)

DX = [-1, 1, 0, 0]
DY = [0, 0, -1, 1]

def read_initial_input():
    N, M, T, U = map(int, input().split())
    V = [list(map(int, input().split())) for _ in range(N)]
    sx, sy = [0] * M, [0] * M
    for p in range(M):
        sx[p], sy[p] = map(int, input().split())

    owner = [[-1] * N for _ in range(N)]
    level = [[0] * N for _ in range(N)]
    px, py = list(sx), list(sy)
    for p in range(M):
        owner[sx[p]][sy[p]] = p
        level[sx[p]][sy[p]] = 1

    return N, M, T, U, V, owner, level, px, py

def get_candidates(N, M, owner, px, py):
    reachable = {(px[0], py[0])}
    queue = deque([(px[0], py[0])])
    while queue:
        x, y = queue.popleft()
        for d in range(4):
            nx, ny = x + DX[d], y + DY[d]
            if 0 <= nx < N and 0 <= ny < N and (nx, ny) not in reachable and owner[nx][ny] == 0:
                reachable.add((nx, ny))
                queue.append((nx, ny))

    candidates = set(reachable)
    for x, y in reachable:
        for d in range(4):
            nx, ny = x + DX[d], y + DY[d]
            if 0 <= nx < N and 0 <= ny < N:
                candidates.add((nx, ny))

    for p in range(1, M):
        candidates.discard((px[p], py[p]))

    return candidates

def read_turn_result(N, M, owner, level, px, py):
    for _ in range(M):
        tx, ty = map(int, input().split())
    for p in range(M):
        px[p], py[p] = map(int, input().split())
    for i in range(N):
        row = list(map(int, input().split()))
        for j in range(N):
            owner[i][j] = row[j]
    for i in range(N):
        row = list(map(int, input().split()))
        for j in range(N):
            level[i][j] = row[j]

def main():
    N, M, T, U, V, owner, level, px, py = read_initial_input()

    for _ in range(T):
        candidates = get_candidates(N, M, owner, px, py)
        tx, ty = random.choice(list(candidates))
        print(tx, ty, flush=True)
        read_turn_result(N, M, owner, level, px, py)

if __name__ == '__main__':
    main()