关键点
地图
- 連想配列呀 名为辞書的数据结构
map允许您处理特定值链接到特定值的数据。map声明
map<Keyの型, Valueの型> 変数名;
map操作
| 操作 | 記法 | 計算量 |
|---|---|---|
| 增加价值 | 変数[key] = value; |
O(\log N) |
| 删除值 | 変数.erase(key); |
O(\log N) |
| 访问值 | 変数.at(key) |
O(\log N) |
| 所属判定 | 変数.count(key) |
O(\log N) |
| 获取元素数量 | 変数.size() |
O(1) |
队列
- 队列呀 名为队列 通过使用的数据结构
queue,您可以执行诸如“逐一添加值并按照添加顺序提取值”之类的过程。queue声明
queue<型> 変数名;
queue操作
| 操作 | 記法 | 計算量 |
|---|---|---|
| 添加元素 | 変数.push(値); |
O(1) |
| 访问第一个元素 | 変数.front() |
O(1) |
| 删除第一个元素 | 変数.pop(); |
O(1) |
| 获取元素数量 | 変数.size() |
O(1) |
优先队列
- 优先队列的数据结构
priority_queue可用于执行“提取迄今为止添加的元素中最大的元素”的过程。priority_queue声明
priority_queue<型> 変数名;
priority_queue操作
| 操作 | 記法 | 計算量 |
|---|---|---|
| 添加元素 | 変数.push(値) |
O(\log N) |
| 获取最大元素 | 変数.top() |
O(1) |
| 删除最大元素 | 変数.pop(); |
O(\log N) |
| 获取元素数量 | 変数.size() |
O(1) |
- 按降序检索值
priority_queue声明
priority_queue<型, vector<型>, greater<型>> 変数名;
STL容器
1.14.STL函数正如我提到的, STL 包括有用的函数和数据类型。 这次我们将介绍其中一些容器类型。 它是一种称为
地图
map是連想配列呀
名为辞書的数据类型。
map允许您轻松处理特定值与特定值关联的数据。
例如,假设您正在处理如下表这样的数据,其中名称(字符串类型的值)与成绩(int 类型的值)链接。
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 89 |
| “查理” | 95 |
这些数据
用map表示,则变为如下。
#include <bits/stdc++.h>
using namespace std;

int main() {
  map<string, int> score;  // 名前→成績
  score["Alice"] = 100;
  score["Bob"] = 89;
  score["Charlie"] = 95;

  cout << score.at("Alice") << endl;   // Aliceの成績
  cout << score.at("Bob") << endl;     // Bobの成績
  cout << score.at("Charlie") << endl; // Daveの成績
}
実行結果
100
89
95
对于以下解释,map处理的数据中,上表中的“名称”是钥匙,“等级”值
我们称之为。
宣言
map声明如下。
map<Keyの型, Valueの型> 変数名;
操作
在下面的每个操作的说明中,使用如下表的数据。
假设它位于一个名为score的变量中。
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 89 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
#include <bits/stdc++.h>
using namespace std;

int main() {
  // 初期状態
  map<string, int> score;
  score["Alice"] = 100;
  score["Dave"] = 95;
  score["Bob"] = 89;

  // (scoreに対する処理)
}
增加价值
変数[key] = value;
例
score的示例。
score["Charlie"] = 70;
添加“查理→70”后立即score的内容如下表所示。
删除
操作前
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 89 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
操作後
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 89 |
| “查理” | 70 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
删除值
変数.erase(key);
key对应的关系。
要从
例
score中删除“Bob→89”:
score.erase("Bob");
删除“Bob→89”后立即score的内容如下表所示。
删除
操作前
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 89 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
操作後
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
访问
変数.at(key)  // keyに対応するvalueが存在しない場合はエラーになる
変数[key]     // keyに対応するvalueが存在しない場合はValueの型の初期値が追加される
仅通过访问来添加新数据可能是错误的来源,所以基本上 我们建议使用
.at,但是 您可以通过使用[]访问它来编写更短的程序。 这是使用
例
.at访问的示例。
cout << score.at("Alice") << endl;  // 100
cout << score.at("Taro") << endl;   // "Taro"に対応する値が存在しないためエラー
[]访问的示例。
score["Bob"] = 90;  // "Bob"の成績を90点に変更
cout << score["Alice"] << endl;  // 100
cout << score["Taro"] << endl;   // 0 (scoreに"Taro"というkeyは存在しないため、0で初期化される)
[]中不存在的密钥
作为访问"Taro"的结果,添加了数据“Taro→0”。
此外,鲍勃的等级已更改,太郎的物品已添加。
操作前
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 89 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
操作後
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 90 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
| “太郎” | 0 |
所属判定
要确定某个Key对应的Value是否存在,请执行以下操作:
if (変数.count(key)) {
  // keyに対応する関係が存在する
}
else {
  // keyに対応する関係が存在しない
}
例
if (score.count("Alice")) {
  cout << "Alice: " << score.at("Alice") << endl;
}
if (score.count("Jiro")) {
  cout << "Jiro: " << score.at("Jiro") << endl;
}
出力
Alice: 100
score的关键是"Alice"存在;"Jiro"不存在,所以Alice: 100。
在此操作中score的内容保持不变。
操作前
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 89 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
获取元素数量
変数.size()
返回存在多少个对应关系。
例
cout << score.size() << endl; // 3
score有如下表所示的三个数据,所以score.size()返回 3。
在此操作中score的内容保持不变。
操作前
| 氏名 | 成績 |
|---|---|
| “爱丽丝” | 100 |
| “鲍勃” | 89 |
| “戴夫” 这是将新成绩数据“Charlie→70”添加到 | 95 |
循环 您可以使用
// Keyの値が小さい順にループ
for (pair<Keyの型, Valueの型> p : 変数名) {
  Keyの型 key = p.first;
  Valueの型 value = p.second;
  // key, valueを使う
}
auto简洁地编写它。
// Keyの値が小さい順にループ
for (auto p : 変数名) {
  auto key = p.first;
  auto value = p.second;
  // key, valueを使う
}
在循环中,按升序(成对比较顺序)检索Key值。请注意,这不是您添加信件的顺序。 这是输出
例
score所有内容的示例。
for (auto p : score) {
  auto k = p.first;
  auto v = p.second;
  cout << k << " => " << v << endl;
}
出力
"Alice" => 100
"Bob" => 89
"Dave" => 95
計算量
元素数量 设置N时每个操作的计算量如下。
| 操作 | 計算量 |
|---|---|
增加价值 [] |
O(\log N) |
删除值 erase(key) |
O(\log N) |
访问值 at |
O(\log N) |
所属判定 count |
O(\log N) |
获取元素数量 size |
O(1) |
队列
创建一个数据结构,执行诸如“逐一添加值并按照添加顺序检索值”等处理。
它被称为队列呀
名为队列
通过使用。
在C++中,STL提供了
可以使用queue。
队列用于常用算法,例如广度优先搜索。
下一张幻灯片显示了队列如何工作的图像。
如果将其制作成单个图像,它将如下所示: 数字代表推送顺序。 这是如何使用
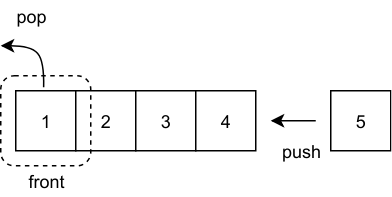
使用例
queue的示例。这与上面幻灯片中描述的行为不同。
#include <bits/stdc++.h>
using namespace std;

int main() {
  queue<int> q;
  q.push(10);
  q.push(3);
  q.push(6);
  q.push(1);

  // 空でない間繰り返す
  while (!q.empty()) {
    cout << q.front() << endl;  // 先頭の値を出力
    q.pop();  // 先頭の値を削除
  }
}
実行結果
10
3
6
1
宣言
您可以声明一个空队列,如下所示:
queue<型> 変数名;
操作
添加元素
変数.push(値);
访问第一个元素
変数.front()
删除第一个元素
変数.pop(); // 先頭の要素が削除される
获取元素数量
変数.size()
要检查队列是否为空,请执行以下操作:
您还可以使用.empty()。
変数.empty() // キューが空ならtrueを返す
計算量
每次操作的计算量如下。
| 操作 | 計算量 |
|---|---|
添加元素 push |
O(1) |
访问第一个元素 front |
O(1) |
删除第一个元素 pop |
O(1) |
获取元素数量 size |
O(1) |
优先队列
执行“提取目前添加的元素中最大元素”的过程时,
我们使用数据结构优先队列。
在 C++、STL 中priority_queue。
优先级队列用于Dijkstra算法等。 还有很多其他情况可以通过充分利用优先级队列来减少计算量。
使用例
#include <bits/stdc++.h>
using namespace std;

int main() {
  priority_queue<int> pq;
  pq.push(10);
  pq.push(3);
  pq.push(6);
  pq.push(1);

  // 空でない間繰り返す
  while (!pq.empty()) {
    cout << pq.top() << endl;  // 最大の値を出力
    pq.pop();  // 最大の値を削除
  }
}
実行結果
10
6
3
1
宣言
空
可以声明priority_queue。
与
priority_queue<型> 変数;
操作
添加元素
変数.push(値);
获取最大元素
変数.top()
queue不同,
请注意,它不是.front()。
另外,请注意它不能被重写。
删除最大元素
変数.pop()
获取元素数量
変数.size()
要检查它是否为空,请执行以下操作:.empty()。
変数.empty() // 空ならtrueを返す
計算量
priorty_queue中的元素数量为N,每次操作的计算量如下。
| 操作 | 計算量 |
|---|---|
添加元素 push |
O(\log N) |
获取最大元素 top |
O(1) |
删除最大元素 pop |
O(\log N) |
获取元素数量 size |
O(1) |
提取最小元素
如下
如果声明priority_queue,则将按降序检索值。
priority_queue<型, vector<型>, greater<型>> 変数;
使用例
#include <bits/stdc++.h>
using namespace std;

int main() {
  // 小さい順に取り出される優先度付きキュー
  priority_queue<int, vector<int>, greater<int>> pq;
  pq.push(10);
  pq.push(3);
  pq.push(6);
  pq.push(1);

  // 空でない間繰り返す
  while (!pq.empty()) {
    cout << pq.top() << endl;  // 最小の値を出力
    pq.pop();  // 最小の値を削除
  }
}
実行結果
1
3
6
10
复制和比较的计算量 复制诸如
vector, string, map, queue, priority_queue之类的容器时,
比较vector呀
名为string所需的计算量为O(N)。
请小心频繁复制包含许多元素的容器的代码,因为计算量可能会增加。
详情
设置
set是一种用于处理一组唯一数据的数据类型。
“仅钥匙map”。实际上
您也可以使用map代替。
set在执行以下处理时很有用。
- 数组中出现的值的类型数量(集合中不重复的元素数量)
- 快速计算某个值是否包含在集合中
- 查找集合中包含的最小值(最大值)
下面是
这是如何使用set的示例。
#include <bits/stdc++.h>
using namespace std;

int main() {
  set<int> S;

  S.insert(3);
  S.insert(7);
  S.insert(8);
  S.insert(10);
  // 既に3は含まれているのでこの操作は無視される
  S.insert(3);

  // 集合の要素数を出力
  cout << "size: " << S.size() << endl;

  // 7が含まれるか判定
  if (S.count(7)) {
    cout << "found 7" << endl;
  }
  // 5が含まれるか判定
  if (S.count(5)) {
    cout << "found 5" << endl;
  }
}
実行結果
size: 4
found 7
宣言
set<値の型> 変数名;
操作
增加价值
変数.insert(値);
如果相同的值已存在,则不会添加。
删除值
変数.erase(値);
所属判定
if (変数.count(値)) {
  //「値」が含まれる
}
else {
  //「値」は含まれない
}
获取元素数量
変数.size()
要检查它是否为空,请执行以下操作:.empty()。
変数.empty() // 空ならtrueを返す
获取最小值
*begin(変数)
在顶部*为必填项。这个表示法将在第 4 章“迭代器”中介绍。
天空
不要对set执行此操作。
请注意,这可能不会导致运行时错误。
获取最大值
*rbegin(変数)
在顶部*为必填项。这个表示法将在第 4 章“迭代器”中介绍。
天空
不要对set执行此操作。
请注意,这可能不会导致运行时错误。
循环 您可以使用
for (auto value : 変数名) {
  // valueを使う
}
循环按升序检索值。请注意,这些值并不按照您添加的顺序排列。
計算量
元素数量 设置N时每个操作的计算量如下。
| 操作 | 計算量 |
|---|---|
| 增加价值 | O(\log N) |
| 删除值 | O(\log N) |
| 所属判定 | O(\log N) |
| 获取元素数量 | O(1) |
| 获取最小值 | O(1) |
| 获取最大值 | O(1) |
堆栈
创建一个执行处理的数据结构,以便“首先检索新添加的项目”。堆栈
它被称为。
在 C++ 中,STLstack。
下图显示了堆栈的工作原理。
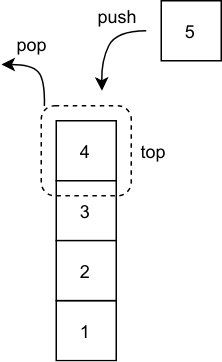
上图中的数字代表推送的顺序。
使用例
#include <bits/stdc++.h>
using namespace std;

int main() {
  stack<int> s;
  s.push(10);
  s.push(1);
  s.push(3);

  cout << s.top() << endl;  // 3 (最後に追加した値)
  s.pop();
  cout << s.top() << endl;  // 1 (その前に追加した値)
}
宣言
stack<値の型> 変数名;
操作
增加价值
変数.push(値);
访问下一个值
変数.top()
删除值
変数.pop();
获取元素数量
変数.size()
要检查它是否为空,请执行以下操作:.empty()。
変数.empty() // 空ならtrueを返す
計算量
元素数量 设置N时每个操作的计算量如下。
| 操作 | 計算量 |
|---|---|
| 增加价值 | O(1) |
| 访问下一个值 | O(1) |
| 删除值 | O(1) |
| 获取元素数量 | O(1) |
双端队列
队列操作“检索第一个添加的项目”
创建一个数据结构,允许您同时执行堆栈操作,例如“检索最后添加的元素”。双端队列
可以使用。
在 C++ 中,STLdeque。 (发音为“甲板”)
是一个类似数组的图像,可以从头到尾添加和删除。 ” 您还可以访问第i个值。
#include <bits/stdc++.h>
using namespace std;

int main() {
  deque<int> d;
  d.push_back(10);
  d.push_back(1);
  d.push_back(3);

  // この時点で d の内容は { 10, 1, 3 } となっている

  cout << d.front() << endl; // 10 (先頭の要素)
  d.pop_front();  // 先頭を削除

  // この時点で d の内容は { 1, 3 } となっている

  cout << d.back() << endl;  // 3 (末尾の要素)
  d.pop_back();  // 末尾を削除

  // この時点で d の内容は { 1 } となっている

  d.push_front(5);
  d.push_back(2);

  // この時点で d の内容は { 5, 1, 2 } となっている

  cout << d.at(1) << endl; // 1
}
宣言
deque<値の型> 変数名;
操作
增加价值
変数.push_back(値);   // 末尾への値の追加
変数.push_front(値);  // 先頭への値の追加
值访问
変数.front()  // 先頭の値へのアクセス
変数.back()   // 末尾の値へのアクセス
変数.at(i)  // i番目へのアクセス
访问不存在的元素将导致运行时错误。 对于
天空
不要对deque调用.front()呀
名为.back()时的行为未定义。
请注意,这可能不会导致运行时错误。
删除值
変数.pop_front();  // 先頭の要素の削除
変数.pop_back();   // 末尾の要素の削除
获取元素数量
変数.size()
要检查它是否为空,请执行以下操作:.empty()。
変数.empty() // 空ならtrueを返す
計算量
元素数量 设置N时每个操作的计算量如下。
| 操作 | 計算量 |
|---|---|
| 增加价值 | O(1) |
| 值访问 | O(1) |
| 删除值 | O(1) |
| 获取元素数量 | O(1) |
unordered_map
C++ STLunordered_map基本功能是
它与map相同,但它是一种可以快速访问和搜索的数据结构。
但是,存在一些限制,例如不能直接使用对作为键。
制約
- 没有定义哈希函数的类型(例如pair和tuple)不能用作键。
- 使用循环提取时,我不知道它们将以什么顺序被检索。
在APG4b中迄今为止引入的类型中,除pair/tuple之外的任何类型都可以用作键。
这里我不会解释哈希函数,但如果你想了解更多,请查阅它们。
計算量
元素数量 设置N时每个操作的计算量如下。
| 操作 | 計算量 |
|---|---|
增加价值 [] |
平均O(1) |
删除值 erase |
平均O(1) |
访问值 at |
平均O(1) |
所属判定 count |
平均O(1) |
获取元素数量 size |
O(1) |
用顺序表示法来说,一切都是平均恒定的时间,由于不断的乘法,实际速度不一定比地图快 请注意。
unordered_set
C++ STLunordered_set是
与unordered_map类似,它速度快但有局限性。set。
制約
- 没有定义哈希函数的类型(例如pair和tuple)不能用作键。
- 我不知道使用循环时它们将以什么顺序提取。
- 无法检索最大值或最小值
計算量
元素数量 设置N时每个操作的计算量如下。
| 操作 | 計算量 |
|---|---|
增加价值 insert |
平均O(1) |
删除值 erase |
平均O(1) |
访问值 at |
平均O(1) |
所属判定 count |
平均O(1) |
获取元素数量 size |
O(1) |
用顺序表示法来说,一切都是平均恒定的时间,由于常量乘法,实际速度不一定比设置快。
lower_bound / upper_bound(STL 函数)
按升序排序要在数组中查找“大于或等于 x 的最小元素”,请使用 STL
您可以使用lower_bound。同样,在求“超过x的最小元素”时,
您可以使用upper_bound。
计算量由数组中元素的数量决定。N然后两者O(\log N)。
使用例
#include <bits/stdc++.h>
using namespace std;

int main() {
  vector<int> a = {0, 10, 13, 14, 20};
  // aにおいて、12 以上最小の要素は 13
  cout << *lower_bound(a.begin(), a.end(), 12) << endl; // 13

  // 14 以上最小の要素は 14
  cout << *lower_bound(a.begin(), a.end(), 14) << endl; // 14

  // 10 を超える最小の要素は 13
  cout << *upper_bound(a.begin(), a.end(), 10) << endl; // 13
}
如何使用
*lower_bound(配列.begin(), 配列.end(), 値)  // 「値」以上の最小の値
*upper_bound(配列.begin(), 配列.end(), 値)  // 「値」を超えるの最小の値
在顶部*为必填项。这个表示法将在第 4 章“迭代器”中介绍。
对空容器的操作
天空
不要对queue调用.front()或空
对于set我们解释说,执行*変数.begin()等操作时的行为是未定义的,并不一定会导致运行时错误。
1.13.配列如中所述#define _GLIBCXX_DEBUG(在 Clang 环境中
可以将#define _LIBCPP_DEBUG 0)写入程序的第一行,以在执行此类操作时生成运行时错误。
#define _GLIBCXX_DEBUG
#include <bits/stdc++.h>
using namespace std;

int main() {
  // ...
}
演習問題
请解决链接目的地的问题。